Buscando, por favor espere.

 Suscribirse

 Imprimir
 Añadir a biblioteca
 Comentar este artículo
Molina Arias M. Principales algoritmos de aprendizaje automático. Parte 3. Evid Pediatr. 2026;22:33.
En artículos previos de esta serie de “Fundamentos de Medicina Basada en la Evidencia” analizamos algunos de los algoritmos de aprendizaje automático supervisado más clásicos, útiles tanto para la predicción de variables cuantitativas como cualitativas.
Como punto común de todos estos algoritmos, su desempeño durante el entrenamiento se evalúa comparando el error entre la predicción realizada por el algoritmo y el valor real, que es conocido por el investigador (el entrenamiento se realiza con datos etiquetados).
Sin embargo, la investigación clínica a menudo nos enfrenta a escenarios donde la respuesta “verdadera” o la etiqueta de la variable resultado es desconocida de antemano. Es en estos casos donde entra en juego el aprendizaje automático no supervisado, una modalidad orientada al descubrimiento de patrones subyacentes sin necesidad de etiquetas previas durante la fase de entrenamiento.
El aprendizaje no supervisado se utiliza con frecuencia como una herramienta fundamental del análisis exploratorio de datos. En lugar de predecir el valor de una variable objetivo, su propósito principal es descubrir estructuras latentes en la información, detectar patrones que pueden ser previamente desconocidos por el investigador o encontrar una forma más eficiente y simplificada de visualizar los datos.
En esta entrega nos centraremos en los dos grandes grupos de técnicas no supervisadas más utilizadas en biomedicina: las técnicas para reducir la dimensionalidad de los datos y los métodos de agrupamiento o clustering.
En el contexto del aprendizaje automático es frecuente encontrarnos con bases de datos complejas, con un alto número de variables. Contra lo que pueda pensarse, un número elevado de variables no siempre es beneficioso, ya que dificulta la comprensión de los datos y el cálculo de las distribuciones de probabilidad. Además, si entrenamos los algoritmos incluyendo el “ruido” de las variables sin poder predictivo, podemos empeorar tanto el sesgo como la varianza del modelo.
En términos geométricos y matemáticos, reducir la dimensionalidad significa transformar un espacio de alta dimensionalidad en un subespacio de dimensiones marcadamente inferiores. De este modo, al mapear los datos hacia este nuevo plano simplificado, se logra eliminar el ruido estadístico y la redundancia de las variables correlacionadas, permitiendo que patrones complejos resulten mucho más fáciles de aislar, visualizar e interpretar sin desvirtuar la esencia ni el poder predictivo de la muestra original.
Imaginemos un conjunto de datos clínicos complejo con un número p de variables explicativas. Dado que nuestras posibilidades de representar gráficamente se limitan a un máximo de tres dimensiones, si un investigador deseara representar la relación de estas variables dos a dos (la forma más habitual), la combinatoria le exigiría elaborar un total de p(p-1)/2 gráficos diferentes. En un escenario clínico real con solo 25 variables, esto se traduciría en la inabarcable tarea de interpretar 300 gráficos por separado.
El análisis de componentes principales (PCA, del inglés, Principal Component Analysis) resuelve este problema reduciendo el número de variables del conjunto de datos original a un número menor de variables llamadas componentes principales, las cuales tienen la ventaja matemática de no estar correlacionadas entre sí.
El PCA asume que, aunque las n observaciones se distribuyan en un espacio p-dimensional, no todas las dimensiones contienen la misma cantidad de información relevante o varianza para el investigador. Así, este algoritmo transforma las variables originales mediante combinaciones lineales para capturar la mayor cantidad de varianza con la mínima pérdida de información posible.
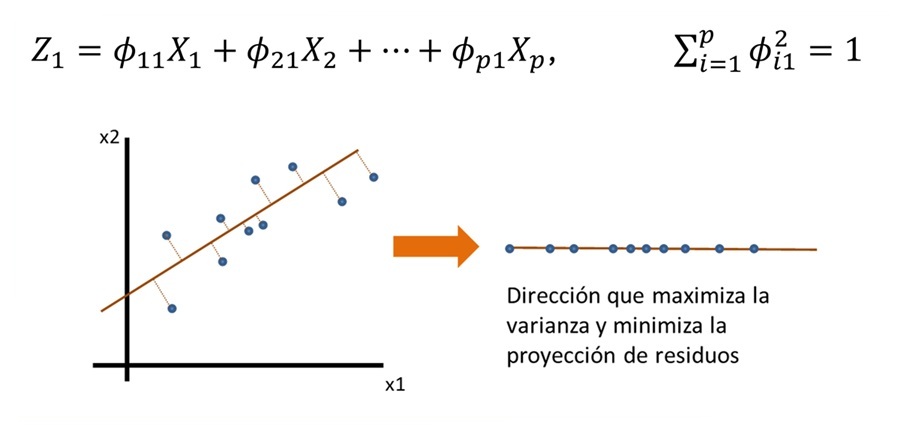
Conceptualmente, cada nueva dimensión encontrada por el PCA es una combinación lineal normalizada de las p variables originales. La primera componente principal (PC1) se define mediante la ecuación:
PC1 = Φ11X1 + Φ21X2 + … + Φp1Xp
Donde Xi representa las variables del conjunto de datos y Φij los coeficientes normalizados (la suma de sus cuadrados debe ser igual a 1).
Desde un punto de vista gráfico, el vector formado por estos elementos define la dirección en el espacio de variables en la que los datos experimentan una mayor variabilidad (Figura 1). Si proyectamos las observaciones originales sobre dicha dirección, obtenemos el vector de esa primera componente principal.
Figura 1. Representación esquemática de la primera componente principal, que es la combinación lineal normalizada de las p variables que explica una mayor parte de la varianza global. El vector de los elementos Φ11, Φ21… Φp1 define la dirección en el espacio de variables en las que los datos varían más. Si proyectamos los datos X1… Xn en esa dirección, obtendremos el vector de esa componente principal Z1. Mostrar/ocultar
Posteriormente, la segunda componente principal (PC2) se calcula como la combinación lineal de las variables originales que explique la mayor cantidad de varianza restante, bajo la estricta condición de no estar correlacionada con PC1. Esta falta de correlación equivale a decir que ambos vectores son ortogonales en el espacio de las variables, es decir, que sus direcciones son perpendiculares entre sí.
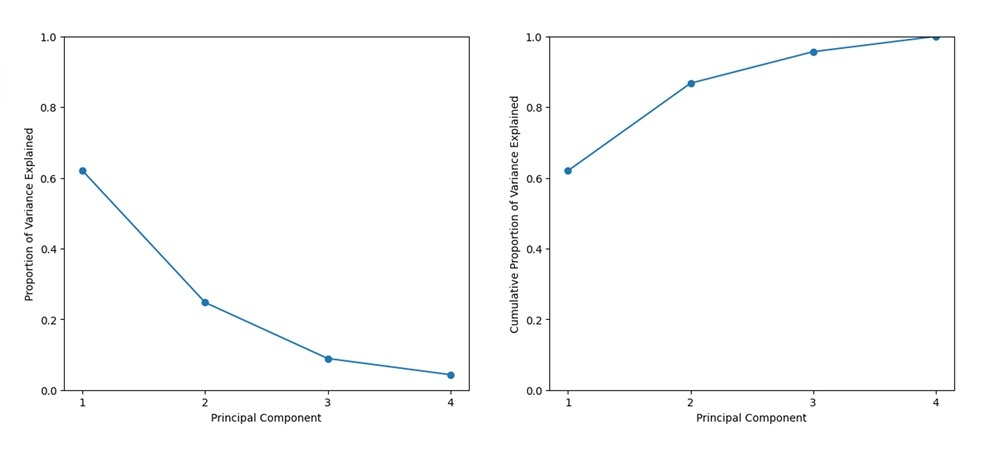
A través de este procedimiento iterativo, es posible calcular un número de componentes principales igual al menor valor entre el número de variables (p) y el número de observaciones menos uno (n - 1). En la práctica, de todo ese total de componentes ordenadas por su varianza (PC1 >PC2 >PC3…), el investigador solo se queda con un número útil mucho menor, seleccionando únicamente las primeras componentes que logren explicar entre el 85% y el 95% de la varianza acumulada (Figura 2).
Figura 2. Representación gráfica de la proporción de varianza explicada por cada componente principal. Vemos en el gráfico de la proporción acumulada como las tres primeras componentes explican más del 90% de la varianza total del conjunto de datos. Mostrar/ocultar
Las aplicaciones del PCA en el ámbito de la salud son diversas y de gran valor práctico:
Antes de aplicar el PCA, es imprescindible estandarizar los datos para que todas las variables tengan media 0 y varianza 1, evitando así que aquellas variables con escalas numéricas mayores distorsionen los resultados. Asimismo, cabe recordar que este algoritmo funciona de manera óptima cuando existe una correlación lineal entre las variables de origen; en caso contrario, es necesario aplicar a los datos transformaciones matemáticas previas. Por último, el investigador debe evaluar siempre la pequeña pérdida de información que se produce al reducir la dimensionalidad del modelo.
Para escenarios complejos donde las relaciones entre las variables son marcadamente no lineales y el PCA resulta insuficiente, se recurre a algoritmos avanzados de reducción de dimensionalidad orientados principalmente a la visualización de datos de alta complejidad (como datos genómicos).
El t-SNE (t-Distributed Stochastic Neighbor Embedding) es una técnica que convierte las afinidades entre puntos de datos en probabilidades condicionales tanto en el espacio de alta dimensionalidad como en el de baja, mapeando los datos de forma que preserva estrictamente las estructuras o vecindades locales (puntos muy cercanos permanecen juntos).
Un algoritmo más reciente es el de UMAP (Uniform Manifold Approximation and Projection), basado en la geometría diferencial que, además de ser computacionalmente más rápido y escalable que t-SNE, consigue un mejor equilibrio al preservar tanto la estructura local de las vecindades como la estructura global del conjunto de datos original.
La representación gráfica de t-SNE y UMAP se manifiesta en mapas bidimensionales o tridimensionales donde los datos de alta dimensionalidad se proyectan como nubes de puntos, logrando separar las observaciones en cúmulos (clusters) nítidos y compactos que preservan de forma óptima las relaciones de similitud y vecindad local de la muestra original.
Los métodos de agrupamiento organizan de forma automatizada un conjunto de datos en subgrupos homogéneos o clústeres, de forma que los elementos que pertenecen a un mismo clúster deben ser lo más similares entre sí (alta cohesión interna), mientras que los elementos asignados a clústeres distintos deben ser lo más diferentes posible (alta separación externa).
Dependiendo de cómo se estructuren los grupos, distinguimos dos tipos fundamentales de técnicas: el agrupamiento no jerárquico y el agrupamiento jerárquico.
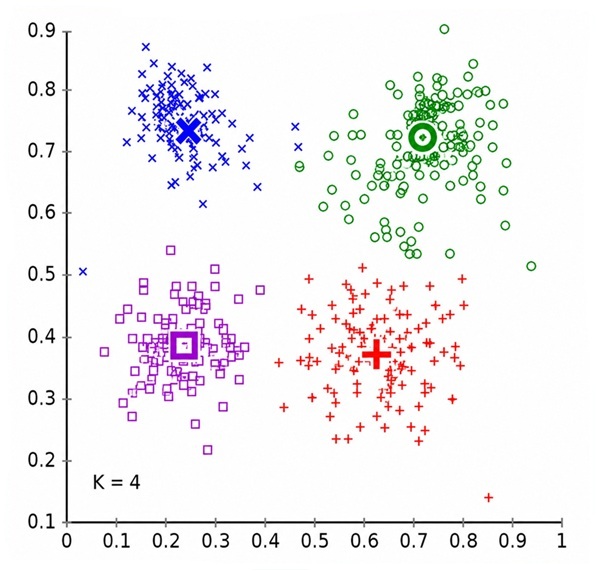
Es el exponente principal del agrupamiento no jerárquico. Su propósito es segmentar un conjunto de n observaciones en un número k de grupos prefijados, en el cual cada observación es asignada al grupo cuyo valor medio (denominado centroide) le resulta más cercano (Figura 3).
Figura 3. Segmentación mediante el algoritmo de k-medias del conjunto de datos en cuatro grupos (k = 4), en el que cada observación pertenece al grupo cuyo valor medio (centroide) es más cercano. Mostrar/ocultar
El funcionamiento práctico de este algoritmo sigue una secuencia iterativa basada en el enfoque de esperanza-maximización:
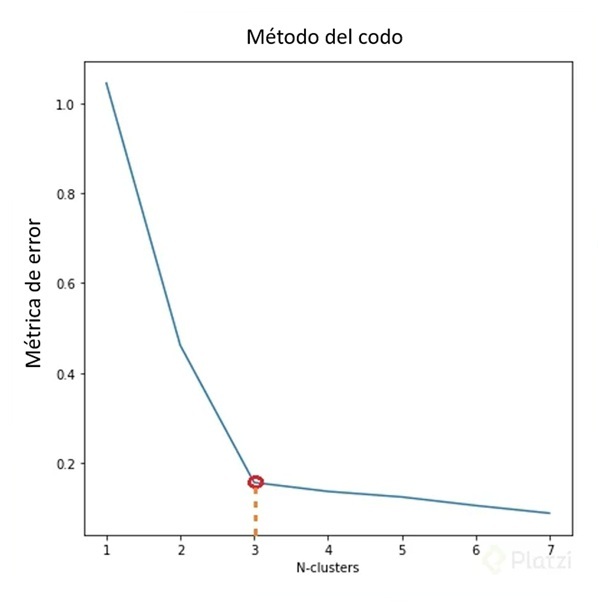
Figura 4. Método del codo. El algoritmo evalúa la función de error con un número creciente de k-medias, de forma iterativa. El punto donde se ve la inflexión del cambio de pendiente de la recta representa el número ideal de grupos. Mostrar/ocultar
Para evaluar el desempeño del modelo sin disponer de una respuesta “verdadera”, se recurre a métricas específicas como el índice de la silueta (valores cercanos a 1 indican una clara separación y alta cohesión; cercanos a 0 reflejan superposición de grupos; y valores negativos delatan que muchos puntos están en el clúster equivocado), el índice de Davies-Bouldin (cuanto menor sea su valor, mejor es la separación de las agrupaciones) o el índice de Calinski-Harabasz (cuanto mayor sea su valor, mejor es la separación y más compactos son los clústeres).
Las principales ventajas del algoritmo de k-medias son su relativa sencillez de comprensión e implementación en la práctica, mostrar una complejidad computacional baja, presentar una excelente escalabilidad aplicable a bases de datos masivas y ofrece una interpretación clara de los resultados, ya que cada grupo queda definido por su centroide (“posición promedio”).
Entre las desventajas, precisa que el investigador especifique el número k de clústeres previamente al análisis, es muy sensible a la inicialización, ya que la elección al azar de los primeros centroides puede afectar notablemente al resultado final y es sumamente sensible a la presencia de valores extremos o atípicos, los cuales distorsionan de forma significativa los centroides. Por último, al basarse en distancias en el espacio euclidiano, no es aplicable de forma directa a variables categóricas sin una normalización y transformación previa de los datos.
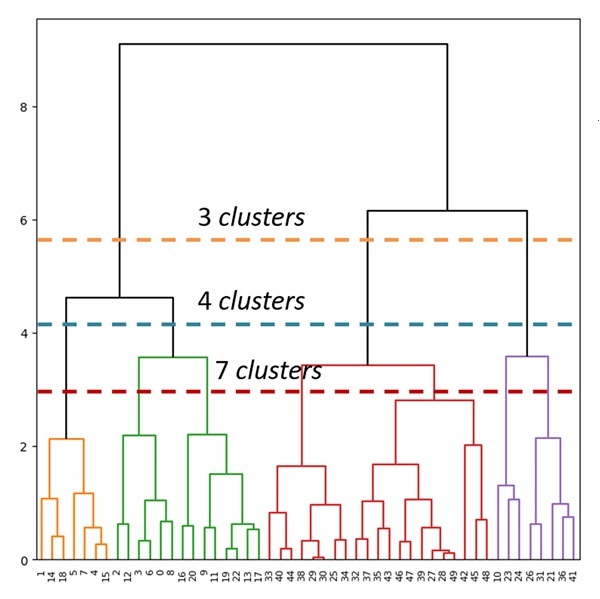
A diferencia de la rigidez de fijar un número de grupos inicial, el agrupamiento jerárquico analiza el conjunto de datos con el objetivo de construir una jerarquía por grupos. El método gráfico habitual para representarlo e interpretarlo es el dendrograma (Figura 5).
Figura 5. Representación gráfica de un dendrograma. Se muestran diferentes puntos de corte que permiten controlar el número final de clústeres obtenidos a partir de un único gráfico. Los clústeres con uniones a bajas alturas mostrarán observaciones con mayor estabilidad y coherencia interna; por el contrario, los formados en una región muy alta del eje, tendrán integrantes menos afines entre sí, con lo que su coherencia diagnóstica puede ser menor. Mostrar/ocultar
Existen dos aproximaciones para su construcción: el método divisivo (un enfoque descendente que comienza con un único clúster global y lo subdivide) y el método agregativo (un enfoque ascendente y el más utilizado en la práctica). El funcionamiento del algoritmo agregativo se ejecuta siguiendo estos pasos iterativos:
Para interpretar correctamente un dendrograma, debe prestarse atención a la orientación del eje vertical, el cual representa la distancia o disimilitud entre las observaciones. Cuanto más alto se encuentren dos ramas al unirse, menor es la similitud entre esas agrupaciones. Las uniones cercanas a la base indican una alta similitud u homogeneidad entre observaciones, mientras que las uniones más altas reflejan conjuntos marcadamente heterogéneos.
La altura del nivel de corte elegida por el investigador desempeña el mismo papel que el valor de k en el algoritmo de k-medias: permite controlar el número final de clústeres obtenidos a partir de un único gráfico. Aquellos clústeres con uniones a bajas alturas demuestran observaciones con gran estabilidad y coherencia interna; por el contrario, si un grupo se forma en una región muy elevada del eje, sugiere que sus integrantes no son tan afines entre sí, reduciendo su coherencia diagnóstica.
Al igual que ocurre con otras técnicas de aprendizaje no supervisado, el investigador debe sopesar una serie de decisiones. El agrupamiento jerárquico requiere definir primero una métrica de distancia (como la euclidiana, Manhattan o correlación) para medir la disimilitud entre observaciones.
En segundo lugar, cuando el algoritmo necesita comparar dos clústeres que ya contienen múltiples observaciones, no basta con medir una distancia lineal simple, ya que existen muchos puntos para valorar. Para resolver esto, los métodos de enlace (linkage) establecen la regla matemática para definir qué tan “lejanos” están esos grupos entre sí. Los más utilizados son el enlace completo (compara todos los elementos de ambos grupos y adopta la distancia del par de observaciones más alejadas entre sí), el enlace simple (hace lo opuesto, tomando la distancia del par de elementos más cercanos), el enlace medio (calcula el promedio aritmético de todas las distancias posibles entre los integrantes de un grupo y el otro), el enlace de centroide (mide la distancia directa entre los centros geométricos de cada cúmulo), y el método de Ward (evalúa matemáticamente todas las opciones de fusión y elige aquella que mantenga los grupos resultantes lo más compactos y homogéneos posible).
Por último, resulta imperativo validar estadísticamente si los clústeres obtenidos reflejan verdaderos patrones clínicos latentes o si el algoritmo simplemente está agrupando el ruido estadístico de la muestra.
Las ventajas del agrupamiento jerárquico son la ausencia de necesidad de establecer el número de clústeres con antelación al análisis y el proporcionar una estructura de relaciones jerárquicas sumamente intuitiva y fácil de asimilar visualmente a través del dendrograma.
Entre sus desventajas, muestra una elevada sensibilidad ante la elección de la métrica de distancia y del método de enlace empleado, resulta computacionalmente más costoso desde el punto de vista de memoria y tiempo cuando se trabaja con grandes volúmenes de datos, y su interpretación se vuelve sumamente compleja si el dendrograma resultante es excesivamente intrincado.
Molina Arias M. Principales algoritmos de aprendizaje automático. Parte 3. Evid Pediatr. 2026;22:33.
 Artículo completo